9880
Манускрипт Войніча. Маньчжурський кандидат
Манускрипт Войніча (МВ або VMS) називають чашею Грааля криптографії. За декілька сотень років тисячі людино-днів було витрачено та продовжують витрачатися у спробах розгадати його зміст та переклад. Причому намагалися люди дуже різні, в тому числі видатні світові криптографи. Поки що виходить не дуже. Дві з невеликим сотні пергаментних сторінок, невідомий алфавіт, невідома мова, каліграфічний впевнений почерк, десятки рисунків невідомих рослин та оголених жінок, що купаються у дивних каналах, зодіакальні астрологічні діаграми — безліч зачіпок, але поки нічого, що дозволило б дешифрувати рукопис. Для будь-кого, хто хоч трохи спробував порозгадувати гачки, МВ є ідеальною головоломкою — яка не має поки відомої розгадки.
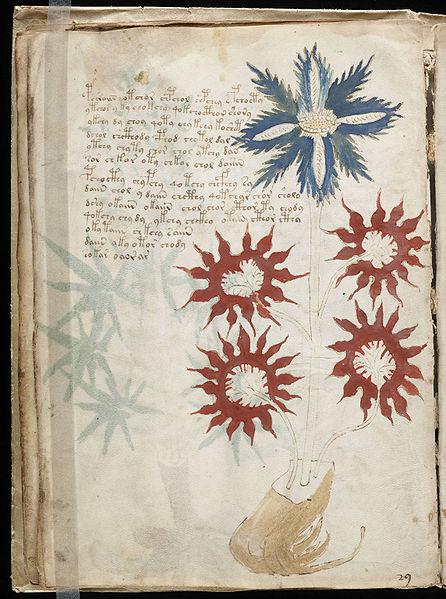
Сторінка 16v
Бачив декілька місяців тому пост на Хабрі про ацтекську мову та ботаніків, які розпізнали декілька центральноамериканських рослин, але все-таки дістану з чернеток свої записи. Їх ціль — познайомити читачів зі світом розгадувачів VMS та моїм не дуже глибоким аналізом однієї з відносно недавніх гіпотез — про маньчжурську мову манускрипта.
Прогулятися по сканам високої роздільної здатності можна тут: Voyage the Voynich Manusript
Вперше з МВ я познайомився із давньої статті в паперовій Комп'ютеррі, але трохи позайматися ним захотілося зараз, після інтерв'ю Лента.ру з автором останнього дослідження Марчелло Монтемурро, опублікованим на PLoS One. Раджу ознайомитися зі статтями у Вікіпедії та Комп'ютеррі та інтерв'ю на Ленті.
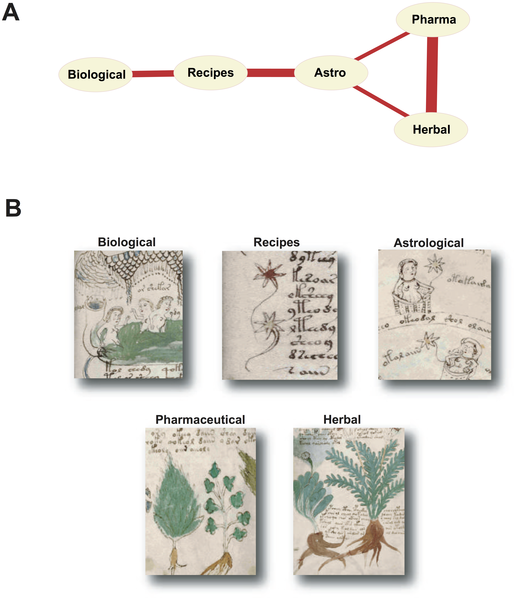
Граф статистичної пов'язаності між частинами манускрипта — рисунок зі статті Монтемурро
За історію розгадування рукопису з'явилася сила-силенна гіпотез про її мову — від європейських (одною або їх суміші) та близькосхідних до зовсім рідкісних та далеких, типу давньояванської або індіанських, носії яких з Європою 15 століття не контактували; не обійшлося і без перекладу з давньоукраїнської. Одні з останніх «проривів» початку цього року — це розшифровка десятка слів британським лінгвістомСтівеном Бексом та спроби прив'язати деякі рисунки та підписи до центральноамериканських ендеміків та індіанських мов. Також чимало дослідників зневірилися та вирішили, що текст — підробка або нісенітниця, абракадабра, створена з метою напустити туману або вразити покупців. Але все ж тих, хто вірить, що МВ — реальний зашифрований текст — набагато більше. Є причини вважати, що це так:
1. Наявність складної структури тексту. Як і всі реальні мови, МВ підкоряється закону Ципфа, тобто частота слова обернено пропорційна його порядковому номеру у відсортованій за частотою послідовності.
2. За ентропійними характеристиками текст близький до європейських мов — латинської, англійської
Пам'ятається, в одній з автобіографічних книг Річарда Фейнмана описується його аналіз альбомних листів нібито невідомих книг з ієрогліфами Майя. У тому оповіданні Фейнману досить швидко вдалося розколоти підробку за допомогою статистичних оцінок та логічних міркувань. Далі він із захватом фантазує — як було б чудово, якщо хтось наважився б створити по-справжньому круту підробку, з урахуванням всіх закономірностей в таких текстах. Якщо комусь колись така підробка вдалася — то це МВ.
У 2003-2004 деякий польський дослідник Збігнев Банасік (Zbigniew Banasik) запропонував маньчжурську версію. Посилань на нього, окрім його листа про Войніча, я не знаходив, лише при написанні цієї статті знайшов публікацію у польській газеті. Google дає переклад, це аматор-лінгвіст та поліглот із села під Вроцлавом… Він запропонував трансляцію алфавіту манускрипта у латиницю та дав початкове тлумачення першої сторінки. Перша сторінка манускрипта 1r — одна з головних цілей атак на VMS, вважається, що розгадавши хоча б її частину, можна отримати ключі до всього рукопису.
Коротка довідка про маньчжурську мову.
Є стаття російської Вікіпедії. Коротко, маньчжури — народ, що жив у північній частині сучасного Китаю та трохи далекосхідній Росії, родом з Прибайкалля та Алтаю. Більш древня назва — чжурчжені. У 17 столітті напали та захопили Китай, спалили Шаолінь, заснували династію Цин, яка правила до початку 20 століття. У цей період офіційний документообіг Піднебесної вівся маньчжурською мовою, у китайських архівах скупчилося колосальне число документів, до яких у дослідників не дійшли руки. Вважається, що хороший історик-китаїст повинен опанувати маньчжурську хоча б для того, щоб прочитати найважливіші документи епохи в оригіналі. З 17 століття у маньчжур був оригінальний алфавіт, але потім вони перейшли на китайські ієрогліфи. Китайці сильно розвинули мову завойовників, додали в неї безліч слів, перевели на маньчжурський Дао Де Цзин та військовий трактат Сунь-Цзи, та в кінці 19 століття успішно асимілювали Маньчжурію. Зараз майже всі маньчжури говорять китайською за виключенням невеликої відособленої народності Сібо. Вже в кінці 19 століття маньчжурську мову вважали вимираючою, зараз її можна вважати майже мертвою.
Історично в Росії XIX ст. склалася потужна школа маньчжурознавців, яка, як пишуть, здала в XX ст. через війни та революції. У мережі можна знайти скан у pdf глибоко пророблений «Повний маньчжурсько-російський словник» І.І. Захарова видання 1875 р. Але в даному випадку зручніше користуватися оцифрованим маньчжурсько-англійським словником Дж.Нормана. Тут можна послухати пісеньку ARKI UCUN з латинським підрядником. Як я зрозумів, назва перекладається на зразок «давайте вип'ємо» або якось подібно.
Маньчжурський офіцер династії Цин, пізні 1700ті, картинка з Вікіпедії

Опис методики
Алфавіт та трансляція
В цілому, я взяв дуже багато з роботи, яку проробив William Porquet. На його сторінці є великий пост A Manchu Skeleton Key to the Voynich Manuscript. З головної сторінки там посилань на нього немає, але він гуглиться, та також я багато цікавого знайшов у кореневій веб-папці, де лежить стаття. Крім цього він залишав посилання на статтю на різних форумах войнічезнавців.
Отже, взявши алфавіт Банасика та його розширення, яке запропонував Porquet, можна перевести текст манускрипта у декілька варіантів тексту на латиниці з невеликим числом додаткових букв. Далі рухаючись у припущенні, що ми отримали деякий текст маньчжурською мовою або ж на одному з його діалектів — вимерлим або змішаним з додатковими словами з іншої мови, ми можемо спробуватися отримати варіанти перекладів кожного слова та фраз із декількох слів. Одне з головних припущень полягає в тому, що слова були написані на слух або ж людиною, що володіла мовою без глибокого знання граматики та орфографії — якщо така була на момент створення. Це значить, що одне слово може бути записане декількома схожими варіантами. На користь цього говорять особливо розповсюджені закінчення ain, aiin, aiiin, daiin, ітд. у нотації EVA (European Voynich Alphabet).
Першим ділом я створив базу для аналізу тексту. По ряду причин було обрано Oracle 11g. Oracle згадано через те, що приклади запитів будуть наводитися на його версії SQL. Зі скриптами ви можете ознайомитися у репозиторії Github. Там викладений набір скриптів, що створюють схему, таблиці та ряд DML SQL скриптів, що наповнюють даними таблиці манускрипта, маньчжурсько-англійського словника та деяких інших.
Отже, нескладною послідовністю регулярних виразів з текстових записів манускрипта в EVA та в розширеному алфавіті Банасика отримуємо скрипти, що імпортують VMS по-рядково, де індекс рядка виглядає як
<page_numberSIDE_LETTER.row_number>. Наприклад, другий рядок першої сторінки рукопису має індекс
<b><1r.2></b>:
Перші 2 рядки VMS у нотації EVA виглядають так (взято з www.voynich.nu/analysis.html):
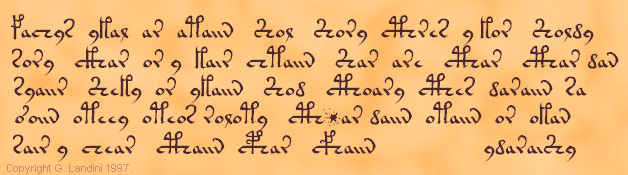
fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy
sory.cKhar.or,y.kair.chtaiin.Shar.are.cThar.cThar,dan
Трансляція буде виглядати так:
'<1r.1> ', 'fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy''<1r.1> ', 'cušil i cum us uhungg tom tosi jolkl i cos tombi''<1r.2> ', 'sory.cKhar.or,y.kair.chtaiin.Shar.are.cThar.cThar,dan''<1r.2> ', 'losi gus os i cuks šhungg tus url jus jus bug'Підпис в кінці п'ятого рядка першого параграфа ydaraiShy перетворюється в ibusurti. Мені здається, що це якесь ім'я власне. У маньчжурському словнику такого слова немає, як я з'ясував через простий пошук в facebook, це може означати людина родом з міста Сурат ( «сонячне місто») на півдні Індії — по-російськи як суртієць. Правда, не маньчжурською, а на хінді або гуджараті…
Порівняння функції подібності
Слова та словосполучення, переведені таблицею з VMS у латиницю, потрібно зіставити зі словами зі словника Нормана. Один запис у словнику містить одне слово або словосполучення з декількох маньчжурських слів великими буквами та їх англійський переклад, що може мати декілька значень. Наприклад:
CŪŠILE crystal
NIYOHOMBI to have sexual intercourse
В CŪŠILE транслюється перше слово fachys на першій сторінці 1r, друге неодноразово миготить у рукописі, включаючи граматично вірні відмінювання у маньчжурському. У цьому ж слові зручно показати додаткові букви: C звучить як тверде «ч», Š — як «ш», Ū — приблизно як «ю».
SOUNDEX
Для початку, щоб проіндексувати та зіставити словник та рукопис я взяв просту функцію SOUNDEX. Це найстаріший фонетичний алгоритм, створений аж в 1918 році та по-моєму використовувався ще до комп'ютерів при переписі населення США. Створивши у таблиці словника та у таблиці, де зберігаються словникові фрагменти рукопису, стовпці з індексом SOUNDEX, можна за ним подивитися варіанти перекладу.
На жаль, SOUNDEX загрібає занадто багато зайвого. Він бере перші 2-3 склади зі слова, переводить їх у літерно-цифровий код, де групи схожих звуків (тобто літер) переводяться в один символ. Детальніше — у наведеному посиланні у Вікі. Але він дає варіанти перекладу на англійську! Це перше наближення, і воно дуже важливе.
METAPHONE
Розвиток фонетичних алгоритмів призвів до створення Metaphone та потім — Double Metaphone. Це більш просунутий варіант порівняння слів. Замість літерно-цифрового коду зі слова або фрази обчислюється чисто літерний код, приведений до одного регістру. Зазвичай голосні прибираються, парні або схожі приголосні згортаються в одного представника. Всі роздільники та нелітерні символи ігноруються. Metaphone з'явився на межі 80х-90х, Double Metaphone — в середині 90х, Metaphone 3 — в 2009. Останній є комерційним софтом, продається разом з невеликою базою для порівняння імен та прізвищ, написаних англійською. Є реалізації Double Metaphone для різних мов, що враховують вимову в них латинських літер та літеросполучень. Є і для російської. Для маньчжурської немає. Я знайшов вільну реалізацію Double Metaphone на PL/SQL, та трохи розширив її, додавши вищеописані літери та ще парочку подібних. У репозиторії вона доступна, там буквально декілька рядків змінено. Так, особливості морфології мови зі всілякими відмінюваннями, суфіксами та приставками він не зловить, але навіть те, що вийшло — дуже цікаво.
З'єднання таблиці з по-слівним нарізанням манускрипта та маньчжурського словника по полю коду METAPHONE (MPH_CODE) через LEFT JOIN.
Нижче в таблиці показані варіанти перекладу першого рядка першої сторінки <1r.1>. Більшість слів має декілька варіантів, але для слова 5 ( uhungg ) та 8 ( jolkl ) їх немає жодного.
'<1r.1> ', 'fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy''<1r.1> ', 'cušil i cum us uhungg tom tosi jolkl i cos tombi'N — номер слова у рядку <1r.1>
NWORD — слово у запропонованому алфавіті
MPH_CODE — метафонівський код слова NWORD
WORD — варіант маньчжурського слова зі словника Нормана, у якого метафонівський код дорівнює коду від NWORD
TRANSLATION — переклад маньчжурського слова
| N | NWORD | MPH_CODE | WORD | TRANSLATION |
|---|---|---|---|---|
| 1 | cusil | CSL | CUSILE | crystal |
| 2 | i | I | I | 1. he, she 2. the genitive particle 3. an interjection used to get the attention of subordinates |
| 2 | i | I | IO | oil, paint, lacquer |
| 2 | i | I | II | see i i |
| 2 | i | I | IOI | 1. a musical instrument made in the shape of a lying tiger--the toothed ridge down the back is stroked with a wooden stick at the conclusion of a musical selection 2. one of the five tones; cf. yumk'a |
| 2 | i | I | I I | 1. (onom.) the sound of sobbing 2. an interjection of derision |
| 3 | cum | CM | CIME | a salt-water fish resembling the salmon |
| 3 | cum | CM | COMO | see coman |
| 4 | us | US | USE | seed, egg (of an insect) |
| 4 | us | US | UCE | door |
| 4 | us | US | USA | exclamation used to get someone's attention |
| 5 | uhungg | |||
| 6 | tom | TM | TOOME | see tome |
| 6 | tom | TM | TOMOO | frame used for weaving nets |
| 6 | tom | TM | TIMU | topic, theme |
| 6 | tom | TM | TOME | (postposition) every, each |
| 6 | tom | TM | TAMA | sole (fish) |
| 7 | tosi | TS | TEISU | 1. assigned place, designated place, responsibility, one's part 2. corresponding, matching, facing, opposite |
| 7 | tosi | TS | TESU | original, local |
| 7 | tosi | TS | TOOSE | 1. weight (for a balance) 2. power, authority, right 3. spindle |
| 7 | tosi | TS | TOSE | see toose |
| 7 | tosi | TS | TESE | plural of tere: those, they |
| 7 | tosi | TS | TES | (onom.) the sound of rope, thread, or a leather thong breaking under stress |
| 7 | tosi | TS | TOSI | white spot on the forehead of an animal |
| 7 | tosi | TS | TSU | vinegar |
| 7 | tosi | TS | TUSA | profit, gain, benefit, advantage |
| 7 | tosi | TS | TUSY | chieftain of a native tribe |
| 8 | jolkl | |||
| 9 | i | I | II | see i i |
| 9 | i | I | IOI | 1. a musical instrument made in the shape of a lying tiger--the toothed ridge down the back is stroked with a wooden stick at the conclusion of a musical selection 2. one of the five tones; cf. yumk'a |
| 9 | i | I | I I | 1. (onom.) the sound of sobbing 2. an interjection of derision |
| 9 | i | I | IO | oil, paint, lacquer |
| 9 | i | I | I | 1. he, she 2. the genitive particle 3. an interjection used to get the attention of subordinates |
| 10 | cos | CS | CECE | silk gauze |
| 10 | cos | CS | CASI | in that direction, thither, there |
| 10 | cos | CS | CESE | register, official record |
| 10 | cos | CS | CISE | vegetable or flower garden |
| 10 | cos | CS | CAISI | see caste |
| 10 | cos | CS | CISU | private, private interest or profit |
| 10 | cos | CS | CISUI | out of one's own interest, on one's initiative, naturally (see also ini cisui), privately, on one's own |
| 10 | cos | CS | COS | the sound of ricocheting or rebounding |
| 10 | cos | CS | CUSE | 1. bamboo 2. silk 3. a cook |
| 10 | cos | CS | CAISE | 1. hairpin 2. a cake made of fried vermicelli |
| 11 | tombi | TMB | TUMBI | to hunt, to pursue |
| 11 | tombi | TMB | TOOMBI | to scold, to rail at, to abuse, to curse |
| 11 | tombi | TMB | TEMBI | 1. to sit 2. to reside, to live 3. to occupy (a post) |
| 11 | tombi | TMB | TAMBI | 1. to get caught on something, to get entangled and trip over something 2. to get caught in a trap or net |
| 11 | tombi | TMB | TUMBI | to hit, to beat, to pound; cf. dumbi |
| 11 | tombi | TMB | TOMBI | see toombi |
Як бачите, деякі слова схожі на вигляд, деякі відстоять далеченько, через майже повне вирізання голосних у коді від слова видаються всі варіанти маньчжурських слів, у яких між приголосними зовсім інші голосні звуки. Короткі одно- та двох-буквенні слова — взагалі «пальцем в небо». Але вже цікаво — набагато цікавіше, ніж шукати за словником вручну з Ctrl-F.
Всього використовувалося три модифікації метафону — початкова англійська та ще дві модифіковані, із додатковими літерами та зі змінами правил згортки.
Пересилання на синоніми у полі перекладу
Невелика корекція словника — до поля перекладу, що містить пересилання «see SOME_OTHER_WORD» через роздільник додається переклад цього синоніма.
Пересилання на синоніми ловляться регулярним виразом.
Наприклад приведений вище у таблиці:
TOSE see toose
відразу доповнюється перекладом посилання:
TOSE see toose :: 1. weight (for a balance) 2. power, authority, right 3. spindle
Морфологія. Відмінювання дієслів за часами
Йдемо далі. Можна зануритися у мову глибше. Дієслова у маньчжурському відмінюються за часами додаванням закінчення. Ось тут наведена таблиця відмінювань з прикладами та відповідностями англійським часам. Можна помітити, що на один англійський Present Continious або Past Continious є декілька різних маньчжурських варіантів. Мабуть вони відображають якісь незрозумілі мені тонкощі або це просто синоніми, але для пошуку відповідностей у Войнічі це не важливо. З таблиці словника робимо та зберігаємо вибірку дієслів у формі інфінітива — тобто всі слова, що закінчуються на інфінітивне закінчення -MBI та мають у полі перекладу підрядок " to ". Прибравши закінчення та зберігши результат в окрему таблицю, отримуємо список дієслівних маньчжурських коренів MANCHU_VERB_STEM.
Наприклад, дієслово AKŪMBI (to die) зберігається як: AKŪ.
З вказаного вище посилання беремо таблицю відмінювань та робимо довідкову таблицю MANCHU_VERB_SUFFIX:
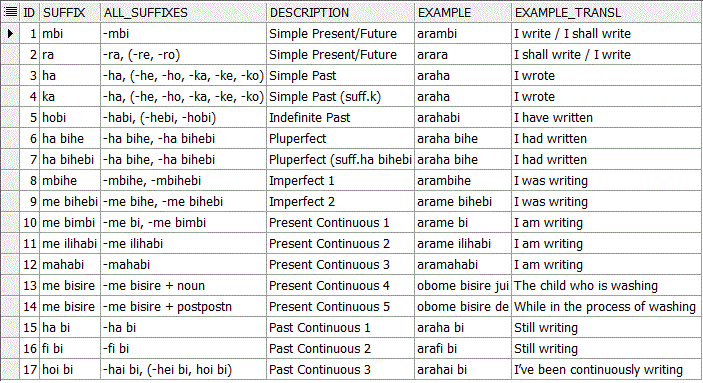
Всі можливі варіанти відмінювань дієслів — це фактично декартовий добуток цих таблиць. Причому пошук у манускрипті проводиться точно так само, за кодом Metaphone, а при відмінюванні до коду кореня дієслова додається метафонівський код закінчення-суфікса. Через це
Даурія в космосі
Резюме космічної розвідки СРСР, види ракет і найбільш значущих перемог у цій галузі. Частина 2