9880
Manuscrito Voynich. El candidato de Manchuria
Manuscrito Voynich (MV o VMS) se llama el Santo Grial de la criptografía. Durante varios cientos de años, miles de días-hombre se han gastado y siguen gastándose en intentos de desentrañar su significado y traducción. Además, la gente muy diferente ha intentado hacerlo, incluyendo criptógrafos mundiales destacados. Hasta ahora, no está funcionando muy bien. Dos centenas de páginas de pergamino, un alfabeto desconocido, una lengua desconocida, una caligrafía segura, decenas de dibujos de plantas desconocidas y mujeres desnudas que se bañan en canales extraños, diagramas astrológicos zodiacales — un montón de pistas, pero hasta ahora nada que permita descifrar el manuscrito. Para cualquiera que haya intentado siquiera un poco desentrañar los ganchos, el MV se presenta como un rompecabezas ideal — sin una solución conocida hasta ahora.
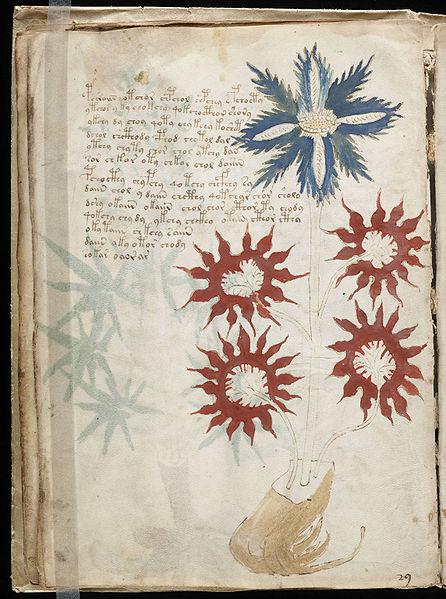
Página 16v
Vi un post en Habrahabr sobre la lengua azteca y los botánicos que identificaron varias plantas centroamericanas hace unos meses, pero aun así sacaré de los borradores mis notas. Su objetivo es presentar a los lectores el mundo de los desencriptadores de VMS y mi análisis no muy profundo de una de las hipótesis relativamente recientes — sobre la lengua manchú del manuscrito.
Puedes dar un paseo por las exploraciones de alta resolución aquí: Voyage the Voynich Manusript
La primera vez que me encontré con el MV fue en un viejo artículo en la Computerra de papel, pero tuve ganas de trabajar un poco en ello ahora, después de la entrevista de Lenta.ru con el autor del último estudio, Marcello Montemurro, publicado en PLoS One. Aconsejo familiarizarse con los artículos en Wikipedia y Computerra y la entrevista en Lenta.
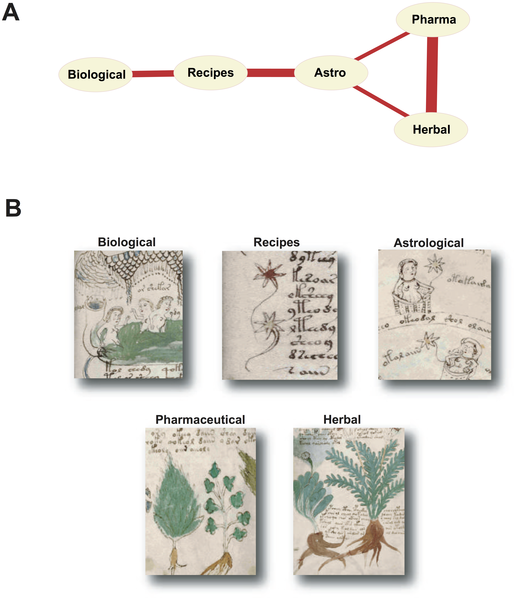
Gráfico de conectividad estadística entre las partes del manuscrito — dibujo del artículo de Montemurro
A lo largo de la historia del descifrado del manuscrito han aparecido un montón de hipótesis sobre su lengua — desde europeas (una o una mezcla de ellas) y de Oriente Medio hasta completamente raras y lejanas, como el antiguo javanés o las lenguas indígenas, cuyos hablantes no contactaron con Europa en el siglo XV; tampoco se prescindió de una traducción del antiguo ucraniano. Uno de los últimos "avances" de principios de este año es la descifración de una docena de palabras por el lingüista británico Stephen Bax y los intentos de relacionar algunos dibujos y firmas con endémicos centroamericanos y lenguas indígenas. También, no pocos investigadores se han desesperado y han decidido que el texto es una falsificación o un sinsentido, una jerigonza, creada con el fin de echar humo u horrorizar a los compradores. Pero, sin embargo, hay muchos más que creen que el MV es un texto encriptado real. Hay razones para creer que esto es así:
1. Presencia de una estructura compleja del texto. Como todas las lenguas reales, el MV obedece a la ley de Zipf, es decir, la frecuencia de una palabra es inversamente proporcional a su número de secuencia en la secuencia ordenada por frecuencia.
2. Según las características de la entropía, el texto es cercano a las lenguas europeas — latín, inglés
Recuerdo que en uno de los libros autobiográficos de Richard Feynman se describe su análisis de hojas de álbum de supuestos libros desconocidos con jeroglíficos mayas. En ese relato, Feynman logró descifrar rápidamente la falsificación utilizando estimaciones estadísticas y razonamientos lógicos. Más adelante, fantasea con entusiasmo — lo genial que sería que alguien se animara a crear una falsificación realmente genial, teniendo en cuenta todas las regularidades de esos textos. Si alguien alguna vez logró tal falsificación, entonces ese es el MV.
En 2003-2004 un investigador polaco, Zbigniew Banasik, propuso una versión manchú. No he encontrado referencias a él, aparte de su carta sobre Voynich, sólo al escribir este artículo he encontrado una publicación en un periódico polaco. Google da la traducción, este es un aficionado a la lingüística y políglota de un pueblo cerca de Breslavia… Propuso una transliteración del alfabeto del manuscrito al latín y dio una interpretación inicial de la primera página. La primera página del manuscrito 1r — uno de los principales objetivos de los ataques al VMS, se considera que al resolver al menos una parte de ella, se pueden obtener claves para todo el manuscrito.
Breve información sobre la lengua manchú.
Hay un artículo en la Wikipedia rusa. En resumen, los manchúes son un pueblo que vivía en la parte norte de la China moderna y un poco de la Rusia del Lejano Oriente, originario de la región del lago Baikal y Altái. Un nombre más antiguo es zhurchzheni. En el siglo XVII atacaron y capturaron China, quemaron Shaolin, fundaron la dinastía Qing, que gobernó hasta principios del siglo XX. Durante este período, el flujo oficial de documentos del Imperio Celestial se realizó en lengua manchú, en los archivos chinos se ha acumulado un número colosal de documentos a los que los investigadores no han echado mano. Se considera que un buen historiador-sinólogo debe dominar el manchú al menos para leer los documentos más importantes de la época en el original. Desde el siglo XVII, los manchúes tenían un alfabeto original, pero luego cambiaron a los jeroglíficos chinos. Los chinos desarrollaron fuertemente la lengua de los conquistadores, añadieron muchas palabras a ella, tradujeron al manchú el Tao Te Ching y el tratado militar de Sun-Tzu, y a finales del siglo XIX asimilaron con éxito Manchuria. En la actualidad, casi todos los manchúes hablan chino, con la excepción de una pequeña nacionalidad separada Sibo. Ya a finales del siglo XIX la lengua manchú se consideraba moribunda, ahora se puede considerar casi muerta.
Históricamente, en la Rusia del siglo XIX surgió una poderosa escuela de estudios manchúes, que, según escriben, decayó en el siglo XX debido a las guerras y las revoluciones. En la red se puede encontrar un escaneo en pdf del "Diccionario completo manchú-ruso" profundamente elaborado de I.I. Zajarov de la edición de 1875. Pero en este caso es más conveniente utilizar el diccionario manchú-inglés digitalizado de J. Norman. Aquí se puede escuchar la canción ARKI UCUN con subtítulos en latín. Como he entendido, el título se traduce como "bebamos" o algo parecido.
Oficial manchú de la dinastía Qing, finales de 1700, imagen de la Wikipedia

Descripción de la metodología
Alfabeto y transliteración
En general, tomé mucho del trabajo que hizo William Porquet. En su página hay un gran post A Manchu Skeleton Key to the Voynich Manuscript. No hay enlaces a él desde la página principal, pero se puede buscar en Google, y también encontré muchas cosas interesantes en la carpeta web raíz, donde se encuentra el artículo. Además de esto, dejó enlaces al artículo en varios foros de voynichólogos.
Así pues, tomando el alfabeto de Banasik y su extensión, que propuso Porquet, se puede traducir el texto del manuscrito a varias versiones del texto en latín con un pequeño número de letras adicionales. A continuación, partiendo del supuesto de que hemos recibido un texto en lengua manchú o en uno de sus dialectos —extintos o mezclados con palabras adicionales de otra lengua, podemos intentar obtener variantes de traducciones de cada palabra y frases de varias palabras. Uno de los principales supuestos es que las palabras se escribieron al oído o por una persona que conocía la lengua sin un conocimiento profundo de la gramática y la ortografía — si es que existía en el momento de la creación. Esto significa que una palabra puede escribirse con varias variantes similares. Esto lo demuestran especialmente las terminaciones generalizadas ain, aiin, aiiin, daiin, etc. en la notación EVA (European Voynich Alphabet).
Lo primero que hice fue crear una base de datos para el análisis de texto. Por varias razones, se eligió Oracle 11g. Oracle se menciona porque los ejemplos de consultas se darán en su versión de SQL. Puede familiarizarse con las secuencias de comandos en el repositorio de Github. Allí se encuentra un conjunto de scripts que crean el esquema, las tablas y una serie de scripts DML SQL que rellenan las tablas con datos del manuscrito, el diccionario manchú-inglés y algunos otros.
Así pues, con una sencilla secuencia de expresiones regulares de los registros de texto del manuscrito en EVA y en el alfabeto ampliado de Banasik, obtenemos scripts que importan el VMS línea por línea, donde el índice de la línea tiene el aspecto de
<page_numberSIDE_LETTER.row_number>. Por ejemplo, la segunda línea de la primera página del manuscrito tiene el índice
<b><1r.2></b>:
Las primeras 2 líneas del VMS en la notación EVA tienen el aspecto siguiente (tomado de www.voynich.nu/analysis.html):
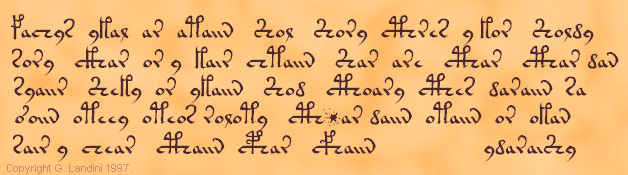
fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy
sory.cKhar.or,y.kair.chtaiin.Shar.are.cThar.cThar,dan
La transliteración se vería así:
'<1r.1> ', 'fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy''<1r.1> ', 'cušil i cum us uhungg tom tosi jolkl i cos tombi''<1r.2> ', 'sory.cKhar.or,y.kair.chtaiin.Shar.are.cThar.cThar,dan''<1r.2> ', 'losi gus os i cuks šhungg tus url jus jus bug'La firma al final de la quinta línea del primer párrafo ydaraiShy se transforma en ibusurti. Me parece que es algún nombre propio. No hay tal palabra en el diccionario manchú, como descubrí a través de una simple búsqueda en facebook, puede significar una persona originaria de la ciudad de Surat ("ciudad soleada") en el sur de la India — en ruso como surtiets. Es cierto, no en manchú, sino en hindi o gujarati…
Comparación de la función de similitud
Las palabras y frases traducidas de VMS al latín mediante una tabla deben cotejarse con las palabras del diccionario de Norman. Un registro del diccionario contiene una palabra o frase de varias palabras manchúes en mayúsculas y su traducción al inglés, que puede tener varios significados. Por ejemplo:
CŪŠILE cristal
NIYOHOMBI tener relaciones sexuales
En CŪŠILE se translitera la primera palabra fachys en la primera página 1r, la segunda aparece repetidamente en el manuscrito, incluyendo inflexiones gramaticalmente correctas en manchú. En esta misma palabra es conveniente mostrar las letras adicionales: C suena como una "ch" dura, Š — como "sh", Ū — aproximadamente como "yu".
SOUNDEX
Para empezar, para indexar y cotejar el diccionario y el manuscrito, tomé simplemente la función SOUNDEX. Este es el algoritmo fonético más antiguo, creado ya en 1918 y, en mi opinión, se utilizaba incluso antes de los ordenadores en el censo de población de los Estados Unidos. Habiendo creado columnas con el índice SOUNDEX en la tabla del diccionario y en la tabla donde se almacenan los fragmentos de diccionario del manuscrito, se pueden buscar variantes de traducción en ella.
Desafortunadamente, SOUNDEX atrapa demasiadas cosas innecesarias. Toma las primeras 2-3 sílabas de una palabra, las traduce a un código alfanumérico, donde los grupos de sonidos similares (es decir, letras) se traducen a un solo símbolo. Más detalles — en el enlace proporcionado en Wiki. ¡Pero da variantes de traducción al inglés! Esta es la primera aproximación, y es muy importante.
METAPHONE
El desarrollo de los algoritmos fonéticos condujo a la creación de Metaphone y, posteriormente, — Double Metaphone. Esta es una variante más avanzada de la comparación de palabras. En lugar de un código alfanumérico, se calcula un código puramente alfabético, reducido a un solo registro, a partir de una palabra o frase. Por lo general, se eliminan las vocales, las consonantes emparejadas o similares se reducen a un solo representante. Todos los separadores y los símbolos no alfabéticos se ignoran. Metaphone apareció en la frontera de los años 80-90, Double Metaphone — a mediados de los 90, Metaphone 3 — en 2009. Este último es un software comercial, que se vende junto con una pequeña base de datos para comparar nombres y apellidos escritos en inglés. Hay implementaciones de Double Metaphone para diferentes lenguas, que tienen en cuenta las pronunciaciones de las letras latinas y las combinaciones de letras en ellas. También hay una para el ruso. No hay ninguna para el manchú. Encontré una implementación gratuita de Double Metaphone en PL/SQL, y la amplié un poco, añadiendo las letras descritas anteriormente y un par de letras similares. Está disponible en el repositorio, allí sólo se cambian unas pocas líneas. Sí, no captará las particularidades de la morfología de la lengua con todo tipo de inflexiones, sufijos y prefijos, pero incluso lo que ha resultado es muy interesante.
Conexión de la tabla con el corte palabra por palabra del manuscrito y el diccionario manchú por el campo del código METAPHONE (MPH_CODE) a través de LEFT JOIN.
En la tabla siguiente se muestran las variantes de traducción de la primera línea de la primera página <1r.1>. La mayoría de las palabras tienen varias variantes, pero para la palabra 5 ( uhungg ) y 8 ( jolkl ) no hay ni una sola.
'<1r.1> ', 'fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy''<1r.1> ', 'cušil i cum us uhungg tom tosi jolkl i cos tombi'N — número de palabra en la línea <1r.1>
NWORD — palabra en el alfabeto propuesto
MPH_CODE — código metafónico de la palabra NWORD
WORD — variante de la palabra manchú del diccionario de Norman, cuyo código metafónico es igual al código de NWORD
TRANSLATION — traducción de la palabra manchú
| N | NWORD | MPH_CODE | WORD | TRANSLATION |
|---|---|---|---|---|
| 1 | cusil | CSL | CUSILE | cristal |
| 2 | i | I | I | 1. él, ella 2. la partícula genitiva 3. una interjección utilizada para llamar la atención de los subordinados |
| 2 | i | I | IO | aceite, pintura, laca |
| 2 | i | I | II | ver i i |
| 2 | i | I | IOI | 1. un instrumento musical hecho en forma de tigre acostado--la cresta dentada a lo largo de la espalda se acaricia con un palo de madera al final de una selección musical 2. uno de los cinco tonos; cf. yumk'a |
| 2 | i | I | I I | 1. (onom.) el sonido de los sollozos 2. una interjección de burla |
| 3 | cum | CM | CIME | un pez de agua salada parecido al salmón |
| 3 | cum | CM | COMO | ver coman |
| 4 | us | US | USE | semilla, huevo (de un insecto) |
| 4 | us | US | UCE | puerta |
| 4 | us | US | USA | exclamación usada para llamar la atención de alguien |
| 5 | uhungg | |||
| 6 | tom | TM | TOOME | ver tome |
| 6 | tom | TM | TOMOO | marco utilizado para tejer redes |
| 6 | tom | TM | TIMU | tema, tópico |
| 6 | tom | TM | TOME | (postposición) cada, cada uno |
| 6 | tom | TM | TAMA | lenguado (pez) |
| 7 | tosi | TS | TEISU | 1. lugar asignado, lugar designado, responsabilidad, la parte de uno 2. correspondiente, coincidente, frente, opuesto |
| 7 | tosi | TS | TESU | original, local |
| 7 | tosi | TS | TOOSE | 1. peso (para una balanza) 2. poder, autoridad, derecho 3. husillo |
| 7 | tosi | TS | TOSE | ver toose |
| 7 | tosi | TS | TESE | plural de tere: esos, ellos |
| 7 | tosi | TS | TES | (onom.) el sonido de la cuerda, el hilo, o una correa de cuero que se rompe bajo tensión |
| 7 | tosi | TS | TOSI | mancha blanca en la frente de un animal |
| 7 | tosi | TS | TSU | vinagre |
| 7 | tosi | TS | TUSA | beneficio, ganancia, ventaja |
| 7 | tosi | TS | TUSY | jefe de una tribu nativa |
| 8 | jolkl | |||
| 9 | i | I | II | ver i i |
| 9 | i | I | IOI | 1. un instrumento musical hecho en forma de tigre acostado--la cresta dentada a lo largo de la espalda se acaricia con un palo de madera al final de una selección musical 2. uno de los cinco tonos; cf. yumk'a |
| 9 | i | I | I I | 1. (onom.) el sonido de los sollozos 2. una interjección de burla |
| 9 | i | I | IO | aceite, pintura, laca |
| 9 | i | I | I | 1. él, ella 2. la partícula genitiva 3. una interjección utilizada para llamar la atención de los subordinados |
| 10 | cos | CS | CECE | gasa de seda |
| 10 | cos | CS | CASI | en esa dirección, allá, allí |
| 10 | cos | CS | CESE | registro, acta oficial |
| 10 | cos | CS | CISE | huerto de verduras o flores |
| 10 | cos | CS | CAISI | ver caste |
| 10 | cos | CS | CISU | privado, interés o beneficio privado |
| 10 | cos | CS | CISUI | fuera del propio interés, por propia iniciativa, naturalmente (véase también ini cisui), privadamente, por cuenta propia |
| 10 | cos | CS | COS | el sonido de un rebote o un retroceso |
| 10 | cos | CS | CUSE | 1. bambú 2. seda 3. un cocinero |
| 10 | cos | CS | CAISE | 1. horquilla 2. un pastel hecho de fideos fritos |
| 11 | tombi | TMB | TUMBI | cazar, perseguir |
| 11 | tombi | TMB | TOOMBI | regañar, increpar, insultar, maldecir |
| 11 | tombi | TMB | TEMBI | 1. sentarse 2. residir, vivir 3. ocupar (un puesto) |
| 11 | tombi | TMB | TAMBI | 1. quedar atrapado en algo, quedar enredado y tropezar con algo 2. quedar atrapado en una trampa o red |
| 11 | tombi | TMB | TUMBI | golpear, batir, machacar; cf. dumbi |
| 11 | tombi | TMB | TOMBI | ver toombi |
Como puedes ver, algunas palabras son similares en apariencia, algunas están bastante lejos, debido a la casi completa eliminación de las vocales en el código de la palabra se dan todas las variantes de las palabras manchúes, que entre las consonantes tienen sonidos vocales completamente diferentes. Las palabras cortas de una y dos letras — son en general "un tiro en la oscuridad". Pero ya es interesante — mucho más interesante que buscar en el diccionario manualmente con Ctrl-F.
En total, se utilizaron tres modificaciones del metafón — la original en inglés y dos más modificadas, con letras adicionales y con cambios en las reglas de plegado.
Reenvíos a sinónimos en el campo de la traducción
Una pequeña corrección del diccionario — al campo de la traducción, que contiene reenvíos "ver SOME_OTHER_WORD", se añade la traducción de este sinónimo a través de un separador.
Los reenvíos a sinónimos se capturan mediante una expresión regular.
Por ejemplo, el anterior en la tabla:
TOSE ver toose
se complementa inmediatamente con la traducción del enlace:
TOSE ver toose :: 1. peso (para una balanza) 2. poder, autoridad, derecho 3. husillo
Morfología. Inflexiones de verbos por tiempos
Sigamos adelante. Puedes sumergirte más profundamente en la lengua. Los verbos en manchú se conjugan por tiempos añadiendo una terminación. Aquí aquí hay una tabla de declinaciones con ejemplos y correspondencias a los tiempos ingleses. Se puede notar que para un inglés Present Continious o Past Continious hay varias variantes manchúes diferentes. Aparentemente, reflejan algunas sutilezas que no entiendo o son simplemente sinónimos, pero para buscar correspondencias en Voynich no es importante. De la tabla del diccionario hacemos y guardamos una selección de verbos en forma de infinitivo — es decir, todas las palabras que terminan en la terminación de infinitivo -MBI y que tienen la subcadena " to " en el campo de la traducción. Eliminando la terminación y guardando el resultado en una tabla separada, obtenemos una lista de raíces verbales manchúes MANCHU_VERB_STEM.
Por ejemplo, el verbo AKŪMBI (morir) se guarda como: AKŪ.
Del enlace anterior tomamos la tabla de declinaciones y hacemos una tabla de referencia MANCHU_VERB_SUFFIX:
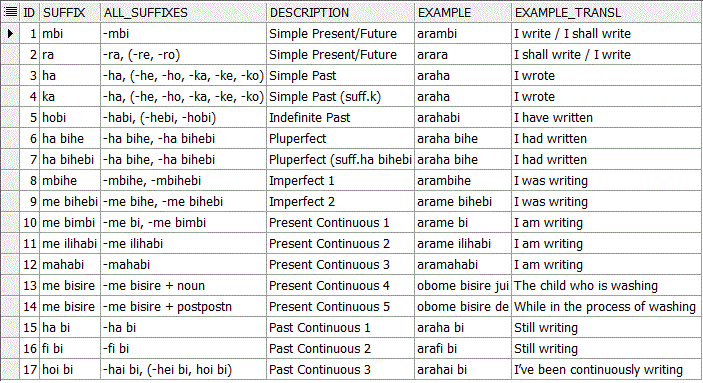
Todas las posibles variantes de declinaciones de verbos — es en realidad el producto cartesiano de estas tablas. Además, la búsqueda en el manuscrito se realiza exactamente de la misma manera, por el código Metaphone, y al declinar al código de la raíz del verbo se añade el código metafónico de la terminación-sufijo. Debido a esto, se pueden despreciar las diferentes variantes de terminaciones para la mayoría de los tiempos.
Por ejemplo, de las declinaciones Simple Past en el diccionario se añaden diferentes terminaciones a diferentes verbos, pero para la búsqueda en el manuscrito cortado al código metafónico sólo se añadirá H o K.
Past -ha (-he, -ho, -ka, -ke, -ko), Ejemplo: araha (Yo escribí)
Así es como se ve parte del código de la representación TRANSL_VERBS21, que da variantes de traducción de combinaciones de una y dos palabras teniendo en cuenta la morfología de los verbos: las variantes de declinaciones se dan a través de una subconsulta interna con UNION ALL:
<code class="sql">SELECT LPAD ( TRIM ( REGEXP_REPLACE (idx, '<([[:digit:]]+)([rv]).([[:digit:]]*)>', '\1')), 3, '0') lpad1, REGEXP_REPLACE (idx, '<([[:digit:]]+)([rv]).([[:digit:]]*)>', '\2') lpad2, LPAD( trim( regexp_replace(idx, '(\.[:digit:]*)>', '\1') ) , 3, '0') lpad3, nw.ID, nw.id_type, nw.n_type, nw.idx, nw.n, nw.nword, nw.sound_code, nw.mph21_code, v.word, v.translation FROM VMS.gonk2_nword nw LEFT JOIN (SELECT VS.STEM || suff.suffix WORD, suff.description || ' : ' || VS.TRANSLATION translation, metaphone21 (VS.STEM || suff.suffix) mph21 FROM VMS.MANCHU_VERB_STEM vs CROSS JOIN VMS.MANCHU_VERB_SUFFIX suff WHERE suff.suffix <> 'mbi' UNION ALL SELECT D.WORD, D.TRANSLATION, D.MPH21_CODE FROM VMS.MANCHU_DICT_JOIN d) v ON NW.MPH21_CODE = v.mph21 WHERE nw.n_type IN (1, 2) </code>
Ejemplo. En la gramática manchú hay todavía muchas variantes de modificación de los verbos con la ayuda de sufijos, pero sumergirse muy profundamente — tomó demasiada energía, así que vamos a ver simplemente cómo se revelan las morfologías del verbo NIYOHOMBI:
<code class="sql">select * from VMS.TRANSL_VERBS21 rt where 1=1 and ( word like '%HOMBI%' or translation like '%niyohomb%' or word like '%NIOH%' )
"Dauria" en el espacio
Resumen de la exploración espacial soviético, tipos de cohetes y las victorias más importantes en este campo. Parte 2