9880
沃尼奇手稿. 满洲候选人
伏尼契手稿(MV 或 VMS)被称为密码学中的圣杯。在过去几百年里,成千上万的人日被花费并且还在花费在尝试破解其含义和翻译上。而且尝试的人非常不同,包括杰出的世界密码学家。目前结果还不是很理想。两百多页羊皮纸,未知的字母表,未知的语言,书法的自信笔迹,数十幅未知植物和裸体女性在奇怪的运河中沐浴的图画,黄道带占星图——许多线索,但到目前为止,还没有任何东西可以让人们破译手稿。对于任何稍微尝试破解线索的人来说,MV 似乎是一个理想的谜题——目前还没有已知的答案。
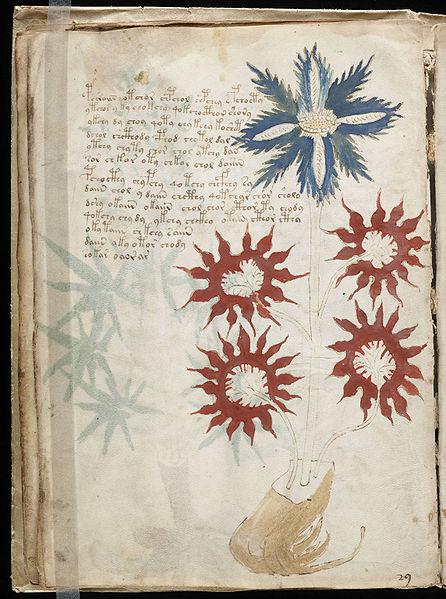
页面 16v
几个月前在 Хабре 上看到了关于阿兹特克语和植物学家的帖子,他们识别出了一些中美洲植物,但仍然会从草稿中取出我的笔记。他们的目标是让读者了解 VMS 的破解者的世界和我对一个相对较新的假设的不太深入的分析——关于手稿的满语。
可以在这里漫步在高分辨率扫描图中:Voyage the Voynich Manusript
我第一次接触 MV 是在《电脑报》纸质版上的一篇古老的文章中,但我想现在稍微研究一下,因为 Ленты.ру 对最后一次研究的作者马切洛·蒙特穆罗的采访,发表在 PLoS One 上。我建议阅读维基百科和《电脑报》上的文章以及 Ленте 的采访。
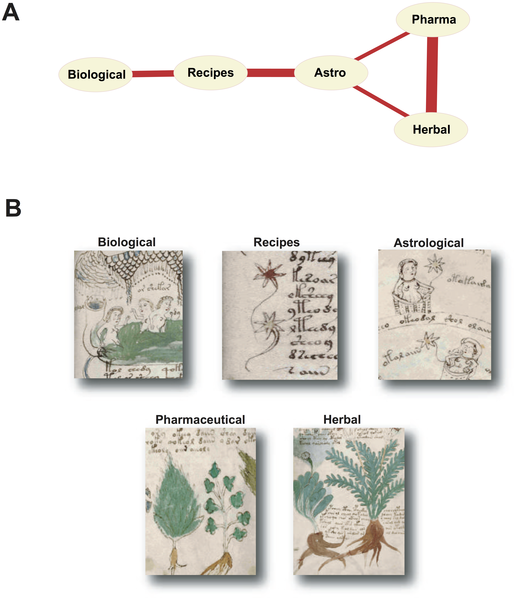
手稿各部分之间统计相关性的图表——来自蒙特穆罗的文章
在破解手稿的历史上,出现了许多关于其语言的假设——从欧洲语言(一种或其混合)和中东语言到完全罕见和遥远的语言,例如古爪哇语或美洲印第安语,这些语言的载体与 15 世纪的欧洲没有接触;也少不了从古乌克兰语的翻译。今年年初的最新“突破”之一是英国语言学家斯蒂芬·贝克斯对十几个单词的破译以及将一些图画和签名与中美洲特有物种和美洲印第安语联系起来的尝试。此外,许多研究人员感到绝望,并认为该文本是伪造的或无意义的,是胡言乱语,目的是制造烟雾或给买家留下深刻印象。但仍然有更多的人相信 MV 是一个真实的加密文本。有理由相信是这样:
1. 文本具有复杂的结构。与所有真实语言一样,MV 服从齐普夫定律,即单词的频率与其在按频率排序的序列中的序号成反比。
2. 根据熵的特征,文本接近欧洲语言——拉丁语、英语
我记得,在理查德·费曼的一本自传书籍中,描述了他对所谓的未知书籍的专辑纸的分析,这些书籍带有玛雅象形文字。在那个故事中,费曼很快就通过统计评估和逻辑推理破解了伪造品。然后他带着热情幻想——如果有人下决心创建一个真正酷的伪造品,考虑到这些文本中的所有规律,那该有多好。如果有人曾经成功地进行了这样的伪造——那就是 MV。
在 2003-2004 年,一位波兰研究员兹比格涅夫·巴纳西克(Zbigniew Banasik)提出了满族版本。除了他关于伏尼契的信之外,我没有找到关于他的链接,直到在撰写本文时才在波兰报纸上找到了一篇出版物。谷歌给出了翻译,他是一位来自弗罗茨瓦夫附近村庄的业余语言学家和多语种专家……他提出了将手稿字母表翻译成拉丁字母,并给出了第一页的初步解释。手稿的第一页 1r——是攻击 VMS 的主要目标之一,人们认为,如果至少破解了其中的一部分,就可以获得整个手稿的钥匙。
关于满语的简要信息。
有俄语维基百科的文章。简而言之,满族人是生活在中国北部和俄罗斯远东地区的一个民族,起源于贝加尔湖地区和阿尔泰地区。更古老的名字是女真。在 17 世纪,他们袭击并占领了中国,烧毁了少林寺,建立了清朝,统治到 20 世纪初。在此期间,中国的官方文件往来都是用满语进行的,中国的档案馆里积累了大量的文件,研究人员还没有接触到这些文件。人们认为,一位优秀的中国历史学家至少应该掌握满语,才能阅读该时代最重要的原始文件。自 17 世纪以来,满族人有一种原始的字母表,但后来他们改用了汉字。中国人极大地发展了征服者的语言,在其中添加了许多单词,将道德经和孙子的军事论文翻译成满文,并在 19 世纪末成功地同化了满洲里。现在,几乎所有的满族人都说中文,除了一个小的孤立的锡伯族。早在 19 世纪末,人们就认为满语正在消亡,现在可以认为它几乎已经死亡。
从历史上看,19 世纪的俄罗斯形成了一所强大的满族研究学院,据称由于战争和革命,该学院在 20 世纪已经崩溃。在网上可以找到 pdf 格式的经过深入研究的“满俄完整词典”的扫描版,作者是 1875 年版的伊万·伊里奇·扎哈罗夫。但在这种情况下,使用 杰里·诺曼的数字化满英词典会更方便。在这里可以听 ARKI UCUN 的歌曲,并附有拉丁语字幕。据我了解,这个名字翻译成“让我们喝酒”或类似的东西。
清朝满族官员,1700 年代后期,来自维基百科的图片

方法描述
字母表和翻译
总之,我从 William Porquet 所做的工作中获得了非常多的灵感。在他的页面上,有一篇很长的帖子 A Manchu Skeleton Key to the Voynich Manuscript。主页上没有到它的链接,但可以用谷歌搜索到,而且我还在根网页文件夹中找到了一些有趣的东西,文章就放在那里。除此之外,他还在伏尼契研究者的不同论坛上留下了文章的链接。
因此,采用了巴纳西克的字母表和他提出的扩展,可以将手稿的文本翻译成几种带有少量附加字母的拉丁字母文本。接下来,假设我们收到了一些满语文本或其一种方言——已经灭绝的或与其他语言的附加词语混合的方言,我们可以尝试获得每个单词和几个单词的短语的翻译版本。主要假设之一是,这些单词是由听觉记录下来的,或者是语言掌握不深,没有深入的语法和拼写知识的人——如果在创建时存在语法和拼写的话。这意味着一个单词可以用几个相似的版本来记录。支持这一观点的是特别常见的结尾 ain、aiin、aiiin、daiin 等。EVA (European Voynich Alphabet) 符号中。
首先,我创建了一个用于分析文本的数据库。由于一些原因,选择了 Oracle 11g。之所以提到 Oracle,是因为查询示例将以其 SQL 版本给出。您可以在 Github 的存储库中查看脚本。那里发布了一组脚本,用于创建方案、表格和一系列 DML SQL 脚本,用于填充手稿表格、满英词典和一些其他数据。
因此,通过一系列简单的正则表达式,从 EVA 和扩展的巴纳西克字母表中获取文本手稿记录,我们可以获得逐行导入 VMS 的脚本,其中行的索引看起来像
<page_numberSIDE_LETTER.row_number>。例如,手稿第一页的第二行具有索引
<b><1r.2></b>:
EVA 符号中的 VMS 前 2 行如下所示(取自www.voynich.nu/analysis.html):
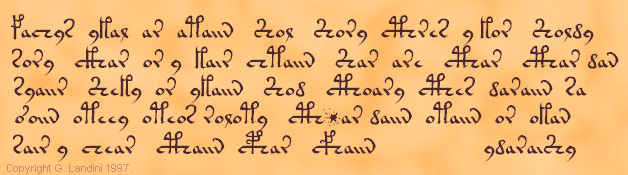
fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy
sory.cKhar.or,y.kair.chtaiin.Shar.are.cThar.cThar,dan
翻译看起来像这样:
'<1r.1> ', 'fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy''<1r.1> ', 'cušil i cum us uhungg tom tosi jolkl i cos tombi''<1r.2> ', 'sory.cKhar.or,y.kair.chtaiin.Shar.are.cThar.cThar,dan''<1r.2> ', 'losi gus os i cuks šhungg tus url jus jus bug'第一段第五行末尾的签名 ydaraiShy 变成了 ibusurti。我认为这是一个专有名词。在满语词典中没有这个词,正如我通过在 facebook 上进行简单的搜索所了解到的那样,它可能意味着来自印度南部城市苏拉特(“阳光之城”)的人——用俄语来说就是苏拉特人。但不是用满语,而是用印地语或古吉拉特语……
比较相似性函数
需要将从 VMS 翻译成拉丁字母的单词和短语与诺曼的词典中的单词进行比较。词典中的一个条目包含一个单词或几个满语单词的短语,用大写字母表示,以及它们的英语翻译,其中可能有多个含义。例如:
CŪŠILE crystal
NIYOHOMBI to have sexual intercourse
在第一页 1r 上,第一个单词 fachys 被翻译成 CŪŠILE,第二个单词在手稿中反复出现,包括语法上正确的满语变格。在这个词中,可以方便地显示附加字母:C 的发音类似于硬“ч”,Š 的发音类似于“ш”,Ū 的发音大致类似于“ю”。
SOUNDEX
首先,为了索引和比较词典和手稿,我使用了 SOUNDEX 函数。这是最古老的语音算法,创建于 1918 年,据我所知,它甚至在美国人口普查之前就已经使用了。通过在词典表格和存储手稿词汇片段的表格中创建带有 SOUNDEX 索引的列,您可以通过它查看翻译的变体。
不幸的是,SOUNDEX 获取了太多不必要的东西。它从单词中获取前 2-3 个音节,并将它们翻译成字母数字代码,其中相似的声音组(即字母)被翻译成一个符号。更多详细信息——请参见维基百科中的链接。但它给出了英语翻译的变体!这是第一个近似值,而且非常重要。
METAPHONE
语音算法的发展导致了 Metaphone 的创建,后来又出现了 Double Metaphone。这是一个更高级的单词比较变体。不是从单词或短语中计算字母数字代码,而是计算出纯字母代码,并将其转换为一个寄存器。通常会删除元音,将成对或相似的辅音折叠成一个代表。所有分隔符和非字母符号都会被忽略。Metaphone 出现在 80 年代末到 90 年代初,Double Metaphone 出现在 90 年代中期,Metaphone 3 出现在 2009 年。后者是一种商业软件,与一个用于比较用英语书写的姓名的小型数据库一起出售。存在针对不同语言的 Double Metaphone 实现,考虑了其中拉丁字母和字母组合的发音。也有针对俄语的实现。没有针对满语的实现。我找到了一个免费的 PL/SQL 版 Double Metaphone,并稍微扩展了它,添加了上述字母和另外几个类似的字母。它在存储库中可用,实际上只更改了几行。是的,它不会捕获语言形态的特征,包括各种变格、后缀和前缀,但即使是结果也非常有趣。
通过 METAPHONE (MPH_CODE) 代码字段将带有单词切割的手稿表格和满族词典与 LEFT JOIN 连接。
下表显示了第一页第一行 <1r.1> 的翻译变体。大多数单词有几个变体,但单词 5 ( uhungg ) 和 8 ( jolkl ) 没有一个。
'<1r.1> ', 'fachys.ykal.ar.ataiin.Shol.Shory.cThres.y,kor.Sholdy''<1r.1> ', 'cušil i cum us uhungg tom tosi jolkl i cos tombi'N - 行 <1r.1> 中单词的编号
NWORD - 所提议字母表中的单词
MPH_CODE - 单词 NWORD 的元音代码
WORD - 来自诺曼词典的满语单词变体,其元音代码等于来自 NWORD 的代码
TRANSLATION - 满语单词的翻译
| N | NWORD | MPH_CODE | WORD | TRANSLATION |
|---|---|---|---|---|
| 1 | cusil | CSL | CUSILE | crystal |
| 2 | i | I | I | 1. he, she 2. the genitive particle 3. an interjection used to get the attention of subordinates |
| 2 | i | I | IO | oil, paint, lacquer |
| 2 | i | I | II | see i i |
| 2 | i | I | IOI | 1. a musical instrument made in the shape of a lying tiger--the toothed ridge down the back is stroked with a wooden stick at the conclusion of a musical selection 2. one of the five tones; cf. yumk'a |
| 2 | i | I | I I | 1. (onom.) the sound of sobbing 2. an interjection of derision |
| 3 | cum | CM | CIME | a salt-water fish resembling the salmon |
| 3 | cum | CM | COMO | see coman |
| 4 | us | US | USE | seed, egg (of an insect) |
| 4 | us | US | UCE | door |
| 4 | us | US | USA | exclamation used to get someone's attention |
| 5 | uhungg | |||
| 6 | tom | TM | TOOME | see tome |
| 6 | tom | TM | TOMOO | frame used for weaving nets |
| 6 | tom | TM | TIMU | topic, theme |
| 6 | tom | TM | TOME | (postposition) every, each |
| 6 | tom | TM | TAMA | sole (fish) |
| 7 | tosi | TS | TEISU | 1. assigned place, designated place, responsibility, one's part 2. corresponding, matching, facing, opposite |
| 7 | tosi | TS | TESU | original, local |
| 7 | tosi | TS | TOOSE | 1. weight (for a balance) 2. power, authority, right 3. spindle |
| 7 | tosi | TS | TOSE | see toose |
| 7 | tosi | TS | TESE | plural of tere: those, they |
| 7 | tosi | TS | TES | (onom.) the sound of rope, thread, or a leather thong breaking under stress |
| 7 | tosi | TS | TOSI | white spot on the forehead of an animal |
| 7 | tosi | TS | TSU | vinegar |
| 7 | tosi | TS | TUSA | profit, gain, benefit, advantage |
| 7 | tosi | TS | TUSY | chieftain of a native tribe |
| 8 | jolkl | |||
| 9 | i | I | II | see i i |
| 9 | i | I | IOI | 1. a musical instrument made in the shape of a lying tiger--the toothed ridge down the back is stroked with a wooden stick at the conclusion of a musical selection 2. one of the five tones; cf. yumk'a |
| 9 | i | I | I I | 1. (onom.) the sound of sobbing 2. an interjection of derision |
| 9 | i | I | IO | oil, paint, lacquer |
| 9 | i | I | I | 1. he, she 2. the genitive particle 3. an interjection used to get the attention of subordinates |
| 10 | cos | CS | CECE | silk gauze |
| 10 | cos | CS | CASI | in that direction, thither, there |
| 10 | cos | CS | CESE | register, official record |
| 10 | cos | CS | CISE | vegetable or flower garden |
| 10 | cos | CS | CAISI | see caste |
| 10 | cos | CS | CISU | private, private interest or profit |
| 10 | cos | CS | CISUI | out of one's own interest, on one's initiative, naturally (see also ini cisui), privately, on one's own |
| 10 | cos | CS | COS | the sound of ricocheting or rebounding |
| 10 | cos | CS | CUSE | 1. bamboo 2. silk 3. a cook |
| 10 | cos | CS | CAISE | 1. hairpin 2. a cake made of fried vermicelli |
| 11 | tombi | TMB | TUMBI | to hunt, to pursue |
| 11 | tombi | TMB | TOOMBI | to scold, to rail at, to abuse, to curse |
| 11 | tombi | TMB | TEMBI | 1. to sit 2. to reside, to live 3. to occupy (a post) |
| 11 | tombi | TMB | TAMBI | 1. to get caught on something, to get entangled and trip over something 2. to get caught in a trap or net |
| 11 | tombi | TMB | TUMBI | to hit, to beat, to pound; cf. dumbi |
| 11 | tombi | TMB | TOMBI | see toombi |
如您所见,有些单词看起来很相似,有些单词相距甚远,由于代码中几乎完全删除了元音,因此从单词中发出了满语单词的所有变体,其中辅音之间完全是不同的元音。简短的单字母和双字母单词通常都是“碰运气”。但已经很有趣了——比手动用 Ctrl-F 在词典中查找有趣得多。
总共使用了三种 Metaphone 修改——原始英语和另外两种修改,带有附加字母和更改的折叠规则。
将同义词转发到翻译字段
对词典进行小的更正——包含转发“see SOME_OTHER_WORD”的翻译字段通过分隔符添加该同义词的翻译。
使用正则表达式捕获转发的同义词。
例如,上表中的示例:
TOSE see toose
立即补充链接的翻译:
TOSE see toose :: 1. weight (for a balance) 2. power, authority, right 3. spindle
形态学。动词的时态变格
让我们继续。我们可以更深入地研究这种语言。满语中的动词通过添加结尾来进行时态变格。以下是这里的一张变格表,其中包含示例以及与英语时态的对应关系。可以注意到,对于一个英语现在进行时或过去进行时,有几个不同的满语变体。显然,它们反映了一些我不理解的细微之处,或者它们只是同义词,但对于在伏尼契中寻找对应关系来说,这并不重要。我们从词典表格中制作并保存动词以不定式形式的选择——即所有以不定式结尾 -MBI 结尾并在翻译字段中包含子字符串“ to ”的所有单词。删除结尾并将结果保存在单独的表格中,我们得到了动词满语词根 MANCHU_VERB_STEM 的列表。
例如,动词 AKŪMBI (to die)保存为:AKŪ。
从上面链接中获取变格表,并制作一个参考表格 MANCHU_VERB_SUFFIX:
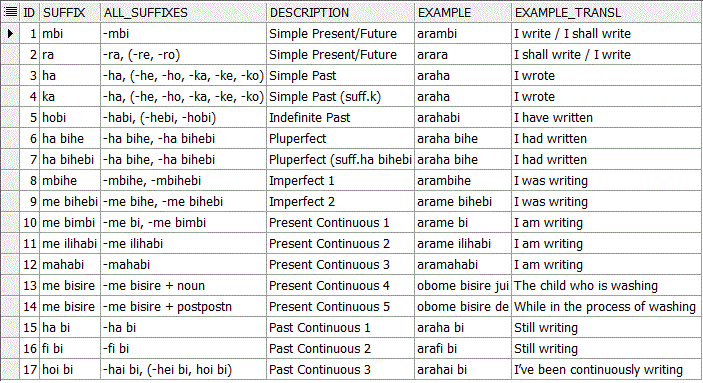
所有可能的动词变格实际上都是这些表格的笛卡尔积。此外,对手稿的搜索以完全相同的方式进行,通过 Metaphone 代码进行搜索,并且在变格时,将元音代码结尾后缀添加到动词词根的代码中。因此,您可以忽略大多数时态的不同变体。
例如,从词典中的简单过去变格到不同的动词添加不同的结尾,但对于根据 Metaphone 代码对手稿进行切割的搜索,仅会添加 H 或 K。
Past -ha (-he, -ho, -ka, -ke, -ko), Example: araha (I wrote)
以下是 TRANSL_VERBS21 表示的一部分代码,该表示立即提供考虑了动词形态的单字母和双字母单词组合的翻译选项:变格的变体通过带有 UNION ALL 的内部子查询发出:
<code class="sql">SELECT LPAD ( TRIM ( REGEXP_REPLACE (idx, '<([[:digit:]]+)([rv]).([[:digit:]]*)>', '\1')), 3, '0') lpad1, REGEXP_REPLACE (idx, '<([[:digit:]]+)([rv]).([[:digit:]]*)>', '\2') lpad2, LPAD( trim( regexp_replace(idx, '(\.[:digit:]*)>', '\1') ) , 3, '0') lpad3, nw.ID, nw.id_type, nw.n_type, nw.idx, nw.n, nw.nword, nw.sound_code, nw.mph21_code, v.word, v.translation FROM VMS.gonk2_nword nw LEFT JOIN (SELECT VS.STEM || suff.suffix WORD, suff.description || ' : ' || VS.TRANSLATION translation, metaphone21 (VS.STEM || suff.suffix) mph21 FROM VMS.MANCHU_VERB_STEM vs CROSS JOIN VMS.MANCHU_VERB_SUFFIX suff WHERE suff.suffix <> 'mbi' UNION ALL SELECT D.WORD, D.TRANSLATION, D.MPH21_CODE FROM VMS.MANCHU_DICT_JOIN d) v ON NW.MPH21_CODE = v.mph21 WHERE nw.n_type IN (1, 2) </code>
示例。在满语语法中,还有许多使用后缀来更改动词的选项,但深入研究占用了太多的精力,所以让我们简单地看一下如何识别动词 NIYOHOMBI 的形态:
<code class="sql">select * from VMS.TRANSL_VERBS21 rt where 1=1 and ( word like '%HOMBI%' or translation like '%niyohomb%' or word like '%NIOH%' ) and n_type = 2 </code>
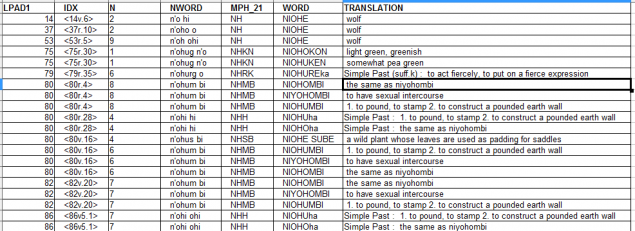
结果
与斯瓦迪士语列表中的单词的交集
斯瓦迪士语列表(Swadesh lists)——基本词汇,一组基本单词,语言学家根据这些单词来评估两种或多种语言之间的关系。例如,此处是一张比较斯拉夫语系中斯瓦迪士语列表的表格。表格还评估了语言随时间变化的速度。这些列表中的基本单词的替换或更改频率远低于其他单词,但它们也会不时发生变化。例如,在俄语中,“глаз”一词是一个外来语,几乎是行话,在 13 或 14 世纪取代了通用斯拉夫语单词“око”。最初的意思是里面有孔的石头。Очи 留在诗歌、谚语和教会文本中。斯瓦迪士语列表有 100、200 和 215 个单词。有人写道,语言学家最常使用最短的 100 个单词的列表。如果感兴趣,请点击此处查看莫里斯·斯瓦迪士的俄语传记。
仅仅为了感兴趣,我将一个包含 207 个单词的大型英满列表记录在一个单独的表格中,并将其与手稿中所有 1 个和 2 个单词的所有翻译进行了交叉,按频率排序。结果是这样的表格——这是最上面的 33 个最常用的单词。这里也不是所有东西都是干净的,因为其中的许多满语单词都以 2 或 3 个变体出现在一个字段中,这意味着在,但对于初步评估——就可以了。
<code class="sql">select T21.NWORD, SWM.ENG_WORD, SWM.WORD, count(*) from VMS.TRANSL_VERBS21 t21 JOIN (select eng_word, upper(word) WORD from VMS.